
| Выравнивание кода в RAM по границе 16 (15.11.2026). |
|
| 2026 - Ноябрь | |
| 15.11.2026 15:05 | |
Чем дальше пишутся статьи в разделе-ит, касательно программирования, - тем трешовее материалы выходят. Ну что это за набор слов, что за нелепица, - а между тем, за этим скрывается скорость работы высоконагруженных и/или высокоточных частей исходного кода. И искажение времени их работы - не флуктуация частоты ЦП или фоновые процессы ОС, это - не выровненный именно исходный код, именно в RAM и кеше L1 процессора, именно по границе... пока неясно: 16 надо, 32 или 64.
Что за дрянь это выравнивание: придётся использовать обобщённое описание - или мозги окончательно вытекут через уши. Компилятор, при подготовке программы и создании EXE-файла, закладывает алгоритмы распределения адресов выполняемых её частей в RAM. Каждая следующая выполняемая строка исходного кода займёт какой-то новый адрес. Если этот адрес не кратен 16 - строка кода будет выполнена медленно, а итоговая скорость зависит от недостающего числа до кратности 16. Конкретно в Borland C++ Builder v.6.0 - смотрится через View - Debug Windows - CPU. 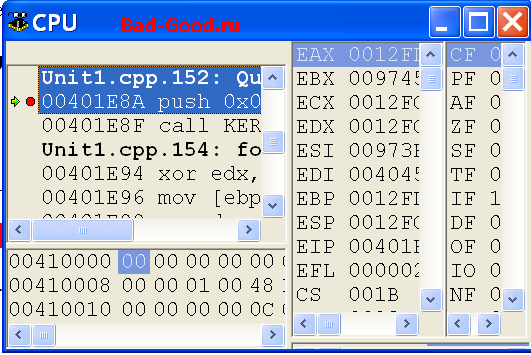 На кратность адреса конкретной строки кода влияет куча факторов: - исходный код, написанный выше (при этом, область искажения зависит от самих исходников: что-то, написанное выше, исказит; а что-то - нет); - какие начальные адреса назначила ОС; - в режиме Release компилятор может просто скрытно удалять куски неиспользуемого кода (пустой цикл, например) - скрытно породит смещение адресов; - в режиме Debug компилятор проводит скрытые оптимизации, в т.ч. процессорные инструкции, - тоже влияет на смещение; - цикличный вызов кусков кода - скрытое смещение для кода ниже. Цикл выполнится 1 раз - сместит на 1 адрес, например. 2 раза вызвал - уже на 2. Похоже, для программы не существует понятия "цикл": она его просто разворачивает на огромный массив адресов и последовательно их выполняет; - попытка узнать текущий адрес, чтобы сделать его кратным 16, - как с электроном: либо скорость его узнаешь толчком другим электроном, либо координату. А электрон-то уже смылся, полученное значение не имеет никакого смысла, если не отнестись к нему с максимальным вниманием (расчёт точного адреса, где будет следующая строка кода после выполнения функции определения текущего уже устаревшего адреса); - самописная функция определения адреса как числа - вернёт один результат. Ровно такая же функция определения адреса как текста (просто перетипирование в конце) - вообще другой. Почти любая изменённая или добавленная/убранная строка кода - искажает корректный результат, убивая весь смысл последующего выравнивания; - нельзя проверить смещение: функция проверки смещения сместит строчку кода ниже на другой адрес; - нельзя сместить внешний адрес внутри внутренностей типа функций, процедур, for, if, while. Если ручной ввод __asm {nop} стабильно смещает на 1 адрес, то вызванный во внутренности он ни к чему не приведёт (видел только, как независимо от количества итераций for с nop внутри - сместил на 1 nop и всё); - внутренний адрес в функции не влияет на внешний при её вызове - так ещё и внешний не влияет на внутренний. Если о практике: - не выровненный пустой цикл 0...4294967295 с неизвестным смещением - выполнялся быстрее на 0.7-0.9с точно такого же пустого цикла, размещённого чуть ниже со своим неизвестным смещением. Гигантская разница, искажающая измерение скорости работы функций процентов на 15; - когда в другой ОС измерил - адреса в памяти там были другие - смещение обоих циклов стало другим - разница вообще до 1с увеличилась - проорался из-за осознания катастрофы; - когда перенёс циклы каждый в свою функцию - вопреки гугловскому выравниванию на 16 (этот тостер будет врать в этом материале ещё очень много), произошло выравнивание на 4. И скорость стала лучше: 0.2-0.39с; - когда вручную выровнял всё по 16 - время стало 0.1-0.15с (а в родительской ОС - вообще 0.048с). Поняв, в какую сторону рыть, решил напрячь гугл для выполнения рутинной работы. Казалось бы, сделанный для облегчения рутины, он должен был ускорить работу в разы: мозги после изучения писеца выше - уже совсем не работали (и палец ещё этот болит). Но оказалось, что гугл тупее человека с прокисшими мозгами. Вместо предложения решения - он начал опять травить байки о pragma, align 16 и прочих вещах, которые в текущей среде программирования не работают (а она была указана в каждом вопросе, это как постоянный префикс уже шло). Пишу, чтобы убрал из себя эти байки, - а он не может редактировать собственную БД - о чём сообщил с невозмутимым видом ржущего капитана Барбоссы (и разработка - временно прервалась по техническим причинам).  Всё крутилось вокруг автоматизации. Смотреть CPU, считать смещение, необходимый сдвиг - ну, может, тут гугл себя проявит, в рутине? 50 функций. Полсотни функций предложил он мне, отлаживая их с бесконечными моими замечаниями после практического тестирования: не работало ни-ху-*. Но, как ни странно, даже такой безумный путь - дал именно корректный результат - что делает ИИ выгоднее современных стажёров, в контексте рутины. Выступая как наставник стажёра-ИИ, была получена функция - возвращающая точный адрес следующей строки исходного кода (в 2 вариантах) и число необходимых nop смещения для кратности 16. Выложу одну сюда - но только чтобы посмотреть, как при ограничении 160 символов на этом сайте - будете копировать её себе; при условии, что скоро она окажется в готовом проекте - и надо тупо подождать. struct strNextStringCode_Adress_RAM { unsigned int uiAddress; //Числовой адрес следующей строки кода. String sAddress_Hex; //Адрес в формате HEX (8 символов). unsigned int uiNops_Needed_16; //Сколько байт NOP (0..15) нужно до границы 16 байт. }; strNextStringCode_Adress_RAM __cdecl Fill_Struct(int dummyParam = 0) { unsigned int* pStack = reinterpret_cast<unsigned int*>(&dummyParam); strNextStringCode_Adress_RAM oNextStringCode_Adress_RAM; //Поправка + 0x0D (13 байт): очистка аргументов __cdecl и вызов деструктора //временной структуры при инициализации переменной. oNextStringCode_Adress_RAM.uiAddress = *(pStack - 2) + 0x0D; oNextStringCode_Adress_RAM.sAddress_Hex = IntToHex(static_cast<__int64>(oNextStringCode_Adress_RAM.uiAddress), 8); oNextStringCode_Adress_RAM.uiNops_Needed_16 = (16 - (oNextStringCode_Adress_RAM.uiAddress & 0x0F)) & 0x0F; return oNextStringCode_Adress_RAM; } Но проблема-то осталась: количество nop есть, но прокрутить-то как? Много что было сделано, всего и не напишешь: - через define ничего не вышло; - топорно: сделать 16 функций с пустым циклом и 16 функций с непустым - в каждой из которых прибавляется 1 nop. Результат - провал: у первой функции нужно 10 nop, у второй - 2; - #include видны только на этапе компиляции - хорошее решение. При запуске функции, в неё инклудится H-файл с пустотой, рассчитывается смещение, файл заполняется nop - при перекомпиляции подтянутся из файла нужное количество nop. Но когда EXE готов - никаких инклудов он не делает. Если не перекомпилировать проект с нужным содержимым файла - ошибка останется. Также в функции останется паразитный расчёт nop: удалишь - сместишься; - прыжок программистской веры: заставил сброситься защиту RAM, перебросить функцию с выравниванием 16, сбросить кеш-инструкции процессора - провал; - а ведь простое решение было на поверхности."Внутренний адрес в функции не влияет на внешний при её вызове - так ещё и внешний не влияет на внутренний" - это не баг, а фича. Инклуды добавлял, функции паразитные вызывал - а адрес внутри минифункции как был со смещением 10 - так и остался. И это - ошибка: нужно было просто много паразитных функций вызвать - и адрес поплыл - внешний влияет-таки на внутренний; - но начало было положено. Вынести код в самый верх CPP-файла - тоже костыль, но он надёжнее костыля выше; - а вот вынести функцию в отдельный CPP-файл и добавить его в верх всего проекта - ... полный провал, опять с подсказки гугла, задрал. В общем, помучившись, - выводы: - __asm {align 16} - простая конструкция в новых языках программирования; - в билдере же - ручное добавление nop - именно когда все исходники уже написаны. И если исходники меняются - о перерасчёте nop надо помнить. Или - костыль с инклудящимся файлом - попроще будет, и функции плевать где находятся; - уменьшение вероятности изменения адреса выравниваемой функции, при ручном вводе nop, - расположение её выше всего остального кода; - выделение ускоряемого участка в отдельную функцию - обеспечивает выравнивание по границе 4. Ни разу за сегодня не было такого, чтобы nop требовалось >12 и не делилось на 4. (добавлено 16.11.2026) Достиг практически идеального выравнивания циклов по критерию времени - 2 пустых цикла работают с погрешностью 0.014-0.034с (а в родительской ОС - стабильные -0.029с). Было-стало в Windows XP и стало в Windows 7. 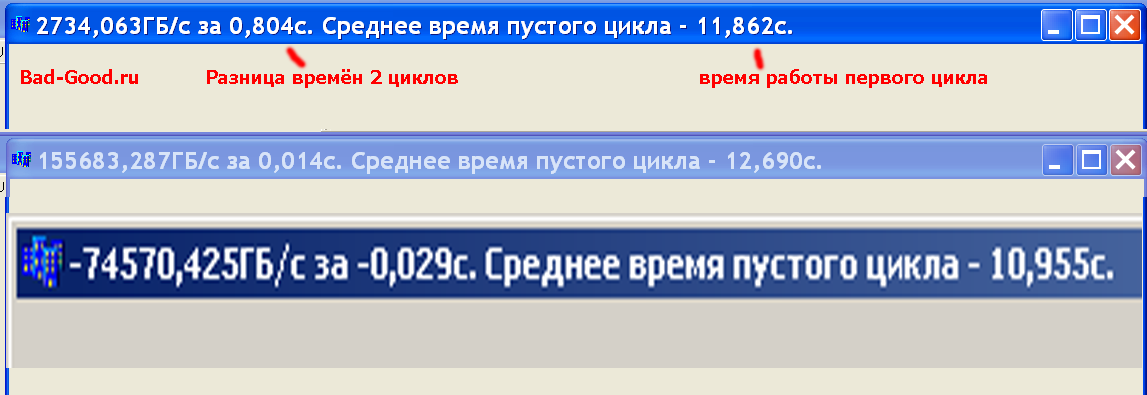 Но самые внимательные читатели уже заметили подвох. Что же произошло? А то, что гугл - пиздабол. Забудьте про выравнивание по границе 16 - нужно не просто выравниваться по границе 4 (или даже 2), а искать оптимальную комбинацию этого выравнивания. Когда перенёс ранее все функции в отдельный CPP-файл, и у них сбились адреса, - выравнивание по 16 ни хрена не помогло. Гугл писал про накладные расходы - это ложь: скрины говорят обратное - настроил-таки. А алгоритм - простой. В жопу даже функцию, возвращающую адрес текущий: - отдельный CPP-файл или отдельная функция - выравнивание по 4; - но это выравнивание - не оптимальное. Нужно прибавлять по 4 nop, сдвигая адрес всё ниже и ниже, - пока экспериментально рассчитанное время не станет минимальным; - так оптимизировался первый цикл, но не смог оптимизироваться второй. Единственная догадка, что прибавлять надо по 2 адреса, а не по 4, - и тупо оптимальный вариант проскочил, сделав больше 16 вставок по 4шт. Поэтому, вместо идеального понижения времени второго цикла: нашёл в нём меньшее время - и подогнал под него первый цикл. Вот что говорит гугл, если ему сказать, что его граница 16 - полное фуфло. У него всегда есть, чем отговориться. Напоминает недопрограммиста из прошлого отдела: ни 1 строчки кода за 12 лет - зато куча идей и объяснений, не имеющих практической значимости и являющихся флудом. 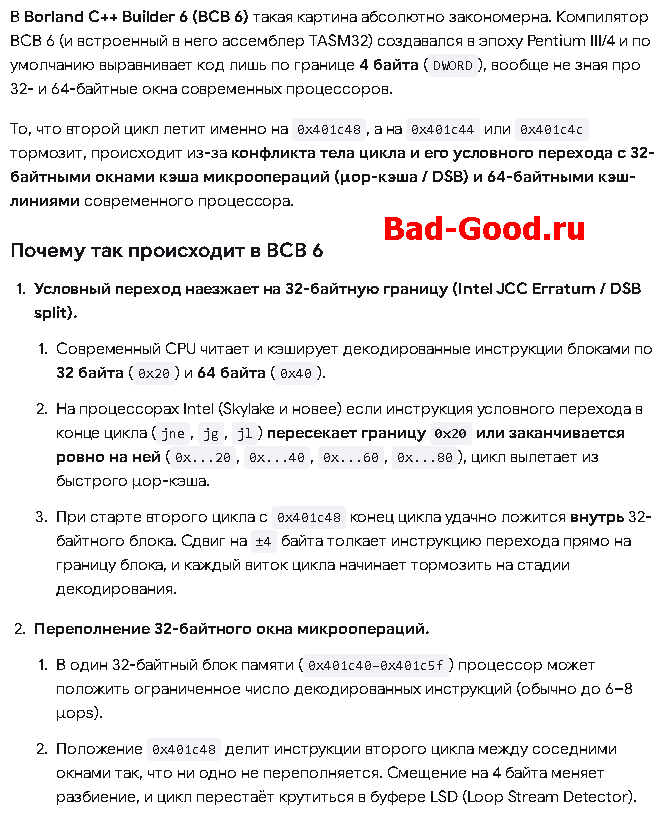  Теперь, когда времена циклов стали одинаковыми, с малой погрешностью и с малой её девиацией (хоть и не минимальными по времени) - это можно внедрять в генератор хаотичных данных 369ГБ/с: чтобы опозорить себя и измерить реальную скорость его генерации ~323ГБ/с... (добавлено 17.11.2026) Теперь - нужно убирать последствия гугла. Могло совпасть, что когда добавил высочайший приоритет (и теперь это полностью подвешивает ОС) - тупо строками кода сверху оба цикла выровнял до разницы 0.1-0.15с. Каждую вероятную строку "разгона" циклов перепроверять надо. ...гугл предложил jmp вместо nop - внутри if (какие перспективы! И что ж ты молчал, сволочь). Отнёсся скептически - и не зря: не заработало. И тут он начинает нести фигню, что смещения просто не видно, - и всё в порядке. Но времена-то выполнения цикла одинаковые при разных "невидимых смещениях". Убейте его... После переноса функционала измерения времени в генератор и повторного ручного выравнивания, стало ясно: - выравнивание точно кратно 4; - но место расположения оптимального адреса неясно. Прибавил 16 nop к циклу - и он заработал быстро - речь точно не о сущности 16; - выравниваемые функции - вверху CPP-файла, насколько это возможно (даже сторонние инклуды ниже). H-файл - инклудится в самой первой строке Unit1.cpp. Посмотрим, на сколько этого хватит при изменении проекта в будущем. Не хватило и на 1 строчку в Form_Create "String sss[5000]" - разница скоростей 2 циклов тут же сбивается. Хоть H-файл располагай в самом верху, хоть CPP-файл делай первым в настройках проекта, хоть линкуй его первым в списке (что после Project1.*, что до), хоть объектный файл делай первым в списке - фиолетово. Но были получены закономерности: - увеличитель частоты системного счётчика времени с 15.6мс до 1мс timerBeginPeriod(1) нужно ставить до функций приоритета (так и не понял, нужны или нет, - хоть и очень критичный вопрос); - расположение сверхточных функций выше других в CPP-файле - защищает их от смены адреса при изменении функций ниже; - расположение в отдельном файле - точно выравнивает по границе 4; - функции тоже могут быть volatile - защитить их от оптимизации. Но не собьёт ли выравнивание по границе 4? Поэтому: сначала написание всех исходников полностью - потом ручное добавление nop по 4шт, найдя максимум или оптимум скорости. Но - с выравниванием сначала по границе 4 единичными nop. Это в моём случае повезло, и в выровненной функции по границе 4 исходники до цикла были написаны так, что сместились на кратное 4 адресам число, - иначе бы совсем запутался. Есть решение средней температуры по больнице - возможно, сделаю, чтобы определить границу: 32, 64 или 128. Мой цикл, с измерением его тиков, занимает 29 адресов. Предполагая минимальную границу 32 - можно добавить 3 nop. И повторять данную конструкцию нужное количество раз с дополнительным смещением 4 nop. Потерпеть, измерить все времена во всех смещениях по границам 4 - и посмотреть, как они себя ведут. Когда же будет определён номинал настоящего выравнивания (вдруг, относительно адреса функции выравнивание надо, а не от адреса 0x00000000, или ещё от какого). Тогда можно и выровнять правильно. А если номинал границы не будет определён - эта функция, с кучей циклов, - будет средней температурой по больнице. Её можно запускать при старте программы, заставляя пользователя ждать, - с меньшим количеством итераций, чем 4.3млрд. И выдавать результат измерения скорости не числом, а диапазоном с вычетом температуры по больнице и её прибавлением. Мне такое решение не подходит - но это выход для тех, кому нужны точные, но не сверхточные вычисления. Напоследок - фишка компилятора. Мне не просто повезло, что было выравнивание по границе 4 начала моего цикла. Компилятор сам всё выравнивает иногда: разница между двумя long double составила 12 адресов вместо 10, при размере в 10Б, - компилятор сам дописал эти 2Б для ускорения работы. А вот почему он после моего цикла адрес не округлил с 29 до 32 - х.з.: делает что хочет и когда хочет. (добавлено 18.11.2026) Полный писец: - произошло неожиданное: компилятор один раз не выровнял функцию по границе 4 - компилятор делает, что ему вздумается. У гугла, несмотря на прошлые клятвенные заверения о границе 4, - куча объяснений, почему это произошло; - в результате, пишу функцию с запуском 128 пустых циклов, каждый раз со смещением 1 nop: чтобы с произвольного адреса функции хоть как-то добраться до истин; - написал функцию сброса кеш-линии переменной (вышибания её из всех 3-х кешей ЦП) - на результат не влияет. Сделал полное отключение оптимизации компилятором участка файла (#pragma option push -Od -r-), запретив так ему и использовать регистры, - на результат не влияет (и не имею права отключать кеширование тестируемых на время функций в будущем: результат скорости будет меньший, чем в действительности). Причём последнее - подразнило: получил 2 результата -0.002с и 0.008с - и больше таких результатов больше никогда не было. Когда функция 128 циклов была отлажена - единичные результаты получились совсем странными. Самый быстрый цикл отработал на адресе 0x4026CF: до кратности и 16, и 32, и 64 - не хватает 15. Другой адрес минимальный 0x40270A: до кратности и 16, и 32, и 64 - не хватает 10. Третий адрес минимальный 402614: до кратности 16 надо 4 - но до 32, 64, 128 надо 20. Ещё не использованы средства выделения всех ресурсов ЦП, подвешивающих систему, - но этим и интересны эти 3 именно неточных результата. Которые вообще непонятно, как интерпретировать. А потом ещё и адрес 0x402714 всё добил. Думаю, надо просто болт забить - сделать ручное выравнивание паре функций и всё. Разброс цикла, при неизменном исходном коде, в зависимости от выравнивания: 11.262-12.644с. Всё чистенько причесал, скорость генератора замерил - да, оказалась меньше, чем была: 304-345ГБ/с (зависит от места запуска: виртуальная машина, родительская ОС и т.д.). И был получен интересный результат: скорости релиза и дебага - практически сравнялись. Значит, полученные алгоритмы, действительно, делают точные измерения, - и только это недовыравнивание мешает выжать максимум. Так как в ОС x64 адрес занимает 8Б, а не 4Б, - естественно, результат в ОС разных битностей - разный. В конкретно текущей настройке проекта - в x64 скорость меньше. Но понравилось то, что эта скорость стала постоянной. Разовый замер пустого цикла и многоразовые замеры непустого с функциями - всегда показывают точный результат, в рамках запущенного места и времени. Запустишь 5 раз подряд EXE-шник - результат с точностью 0.5-1%. Пройдёт время, запустишь ещё 5 раз подряд - получишь результат больше предыдущего на 3%, но одинаковый в рамках 5 запусков. Это значит, что используемые парадигмы создания ультраточной функции измерения времени выполнения других функций - можно попытаться оформить в виде отдельного модуля, в бросовом проекте - для демонстрации. |
|
| Обновлено ( 18.11.2026 18:09 ) |