
| Энтропия хи-квадрат (13.11.2026). |
|
| 2026 - Ноябрь | |||
| 13.11.2026 17:57 | |||
У этих 3 алгоритмов энтропии есть общее начало (из-за этого, опять ставится под сомнение их эффективность и внедрение): они опираются только на количество повторений одного и того же числа в байте - в блоке данных 256Б и во всех данных в целом. Вот с этого момента - начинается программистский треш: - почему существует отдельная профессия: программисты-математики. Они круче программных инженеров: знают, как оптимально закодить всё это математическое непотребство в виде алгоритма. Они скажут: нужен цикл, перебрать весь файл, безо всяких разбиваний на блоки, - и посчитать всё в один массив unsigned int[256]; - почему существует отдельная профессия: программные инженеры. Они круче программистов-математиков: берут их алгоритмы - и кодят исходники по критерию максимально быстрого выполнения. Я одного такого видел, совместившего в 2008 году обе профессии, - огромная зарплата, и кодил быстрый код с первого раза - с него вся комната охреневала; - ну а я кто такой? Ладно, до первого решения ещё догадаться можно. Но что быстрее: цикл unsigned int в цикле unsigned __int8 - или цикл unsigned long (или LARGE_INTEGER, если long=int=4Б)? Ведь файлы-то сейчас таких размеров, что unsigned int переполнится как пить дать. И никакой ИИ не убедит своими теориями, что что-то быстрее или медленнее: тестировать надо по факту. И выкинуть функцию расчёта энтропии Шеннона на хрен из своей программы: это медленное говно с форума анализирует файл максимум 200МиБ за секунд 30-40 - заколебался 1000 итераций высчитывать для точного расчёта энтропии; - вот почему парное программирование остаётся мегаэффективным - но бизнес (даже окологосударственный) уничтожил его как класс; повесив на программиста и программирование, и тестирование, и составление документации, и сопровождение (с командировками, да). Удивляетесь, почему отечественное ПО глючит? Привет от развала СССР и пришедшего капитализма: жрите, не обляпайтесь, - а дальше, с учётом тупизны приходящего стажироваться молодняка уже лет 10, будет ещё хуже. Имея полученный массив, нужно посчитать отклонение от нормы каждого элемента. Если в данных N блоков по 256Б, и все байты в 256Б уникальны, - во всём массиве будут числа N. Отклонение от нормы N будет нулевое - формула "отклонение2 / N" даст 0, норму. Если же каких-то чисел больше, каких-то меньше - сумму этих отклонений начнёт кидать в диапазоне ненормы [-1;1]. Вот с этого момента - начинается программистский треш: - так какую точность использовать для расчёта дробного числа формулы, от float до long double? Ведь это напрямую влияет на скорость; - файл грузить участками по 1МиБ, 10МиБ или 200МиБ? Ведь замечено в стеке: большой массив анализируется медленнее, чем небольшой. Указателем работать с ним или поблочно из массива данные вытаскивать? Ведь работа с указателями намного быстрее элементов массива; - если энтропия Шеннона покажет одну ненорму по своей таблице, а энтропия хи-квадрат другую ненорму, - кому верить; - где математические градации ненормы? 0.1 - это хорошо, а 0.2 - уже конец света? Гугл выдаёт таблицу, но стоит ли ей верить? Там вообще норма 0.5 по модулю. 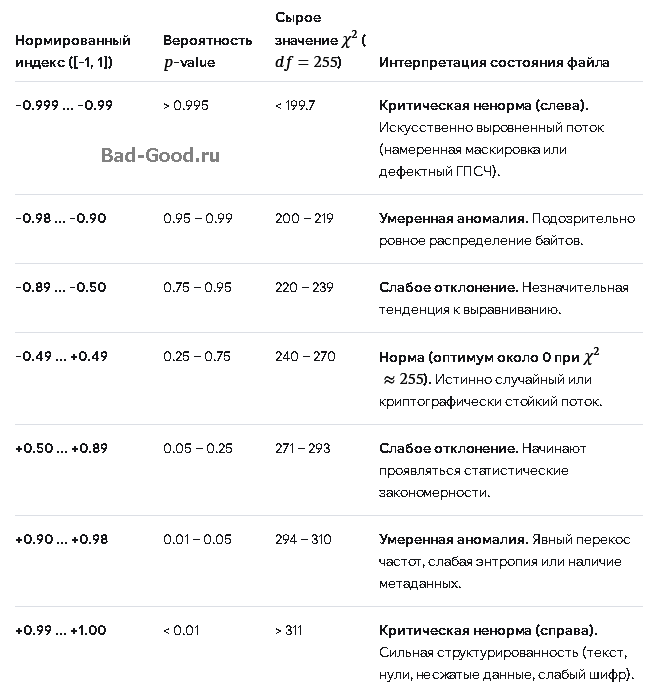 В общем, ещё кодить и кодить, чтобы хоть что-то вменяемое получить; несмотря на простую математику (хотя: что Шеннона, что Реньи, что хи-квадрат - в википедии такие формулы, что глаза на лоб лезут поначалу). А хи-квадрат ещё и нецентрируемым бывает - вот где лютый писец по преобразованию математических кракозябр в простые алгоритмы. |
|||
| Обновлено ( 14.11.2026 13:01 ) |