
| Быстрая рандомизация данных-5 (02.11.2026). |
|
| 2026 - Ноябрь | |
| 02.11.2026 00:00 | |
Предыдущие материалы (раз, два, три, четыре). Ускоренный генератор имел скорость 1.69ГБ/с - мало, надо было ускорять больше. Но особенность ОС Windows - уничтожила весь процесс. Когда работал в Astra Linux - всегда при инициализации массивов мешал мусор в них, это была головная боль. А вот Windows, оказывается, затирает именно нулями всю оперативную память, которую эта программа использовала, - не просто при выходе, а даже при её краше. Сунулся в стек именно проверить данные - одни нули, несколько символов только есть. Сунулся в кучу - то же самое. Гугл трындит вовсю: если есть мусор - это именно от собственной программы: формы динамические, весящие много, старые и массивы и прочее. И это - в Windows XP SP2, значит - да, эта очистка очень давно в Windows есть. Пришлось сделать откат назад: к найденному в интернете и переработанному примеру ускоренного генератора. Его скорость в 2-3 раза меньше, чем идея с массивами и стеком, - нужно было придумать, как его ускорить; а также разработать новый алгоритм его использования. Внезапно, на арену выходит гугл и впервые в жизни делает что-то действительно полезное. У ускоренного генератора оказался критический баг: несмотря на входной параметр 232-1 - создавал числа только 215-1. Вообще без энтузиазма (он столько мне дерьмовых советов давал до этого), засунул функцию в гугл и сказал исправить ошибку. И он нашёл ошибку, исправил - и ещё ускорил этот генератор. После этого, я пытался ускорить этот генератор сам. Принудительное использование регистров, ассемблерная вставка (бвеее!!!), переход на макрос, использование __fastcall, static наружу вынес, static убирал - не меняется скорость, ни на 1мс/Б. Даже заменил на алгоритм XORShift Джорджа Марсальи - скорость уменьшилась в 3 раза (старые компиляторы не переваривают его корректно - возможно, в новых средах программирования, профит будет). Этот генератор чисел, с перепроверкой его скорости относительно XORShift в другой среде, - уже можно выносить в раздел "мои программы": дальнейшее - это создание своих личных генераторов на его основе. Эта функция - включается в состав ядра любой программы. Потому что то, что сейчас начнётся ниже, - это пока немножко треш. Теперь генерация чисел работала с условной скоростью не 635мс/Б, а 381мс/Б. Не 237мс/Б, как было в случае со стеком, - но уже что-то начинает вырисовываться. Потом подумал: а кто сказал, что функция генератора должна быть одна. Убрал побитовое копирование - генератор начал работать без входного параметра (всегда думая о максимуме 232-1), скорость увеличилась до 371мс/Б. Оттестировал - теперь после 400млн генераций - минимум приближен к нулю или равен ему, максимум приближен к 4294967295 или равен ему. По хорошему, инструмент статистического тестирования бы для него запрограммировать: для получения частотного словаря. Но тут требуется 4.5ГиБ RAM только на сам тест - в 32-битной версии Windows XP это невозможно (да и билдер, кажется, ограничение на массив(ы?) всего 2ГиБ имеет). Но можно вывести статистику не по единицам чисел, а по их десяткам, - кажется, у этой статьи потом будет небольшое дополнение (но считаться, чувствуется, будет очень долго: для нормальной статистики нужно не менее 4300млрд запусков). Произошёл казус. Ранее, деля выходное число такого генератора на 1000000.0, - на выходе получалось не 4Б, а 10Б long double. Это было выгодно, пока генератор был медленным. Теперь, добавляя в него эту строку, - его скорость падала до 575мс/Б, полная бессмыслица. Но подумал и оставил эту третью версию генератора: родилась идея создания репозитория псевдомусора, чтобы из него пытаться делать мусор уже хаотичным. Просто динамический массив long double, миллион элементов по 10Б, - заполняется третьей функцией генератора за десятки миллисекунд. Потом используется массив long double на 10 элементов - и заполняется ldJunk_Junk_Array[i] = ldJunk_Array[ldFast_Random_Input(1000000)]. Медлительность генератора long double - окупается данной конструкцией, и на этапе заполнения просто 1 из 10 элементов массива - была получена скорость 253мс/Б - практически приблизился к времени парадигмы со стеком 237мс/Б. Мало, хочу больше. Массив char[512] - можно заполнять по-разному. 52 раза long double - ну как-то долго, время даже хуже станет немного. Наконец-то получается возможность использовать memcpy: она только с третьего байта ручного копирования без переменных - начинает давать профит в скорости. Вот совершенно тупо: сначала сразу эти 10 элементов отправить в char (for - главный враг скорости, memcpy - быстрее ручного). Потом 10 элементов - скопировать в обратном порядке (инвертировать массив таким способом, что компилятор сделает быстро: попарно). Во время добавления перевёрнутого массива, запутался в числах в char при просмотре - если даже кто-то заподозрит подмену истинной информации на хаотичную, хрен он разберётся. Потом - вычесть из всего массива на 10 элементов, скажем, миллион и несколько знаков от балды после запятой. Long double - хорош своей хаотичной мантиссой, она и превращает псевдохаос в хаос: хоть число 0.0003 туда помести - нулей слева практически не будет из-за бешеной точности типа данных. Вычел миллион с гаком - мантисса тут же поменялась и начала занимать больше места. А т.к. она хаотична, - никто не поймёт вычета этого миллиона+: это будет полностью другой набор из 10 целых чисел. Попросите гугл вывести несколько представлений разных чисел long double в байтах: если число не целое - там нулей практически нет. Для чего в генераторе long double и стоит деление на миллион: чтобы 100% породить дробную часть, и относительно глубокую. Итого: исходные 10 long double - первые 100Б в начало массива. Перевернул - ещё 100Б в конец массива. Вычел число у всех 10 long double - породил ещё 200Б хаотичные и повторил что выше. Прибавил число - ещё 200Б - перебор - вручную оставшиеся 12Б заполнил. Результат - 270мс/Б для 512Б выходного хаоса. Ну никак не хочет ускоряться. Заменил переворачивание массива на прибавление константы всем элементам - опять 270мс/Б. Не получилась скорость лучше, чем в предыдущем материале, - однако хаос теперь порождается настоящий. Обиделся. Возмутился. Напрягся. Нужно было ускорить изменение 10 чисел в массиве long double. Ассемблер - не помог (да и ну его в...). __fastcall - не помог. Внезапно, помог define: написав простейшую функцию прибавления через указатели - и исходники прозрачные вышли (100Б записал, хаос изменил, ещё 100Б после предыдущих записал - и т.д.), и время стало... 267мс/Б. А перетипирование long double в char - гугл говорит, что быстро, - делаешь - время до 284мс/Б увеличивается. То есть, ИИ, как я: бьёт совершенно вслепую; но только я могу проверить результат на практике, а он нет, - вот и предлагает бредовые решения. У него 1 раз прикол был: его зациклило между 2 решениями: пишу "медленно" - предлагает второе, пишу "медленно" - предлагает первое.  Ну а дальше - то, что должно было произойти. Если прибавление числа к long double, даже константы, перемешивает ему все байты - зачем мне миллион данных в куче, если я могу 10 в стеке. Время уменьшилось до 253мс/Б. Еле-еле - вышел на уровень, который хотел при куче (ну почти). Причём, последние 2 байта (5 раз по 100Б в массив 512Б) - изрядно достали: memcpy крашится при попытке взять 2Б из long double (скрытно, ближе к концу цикла), перетипирование - слишком долго. Ну, написал тупо переменную цикла, который порождает массивы 512Б: i*i и i*i*i. Прокатило... И даже время уменьшилось: 238мс/Б - вот и подошёл ко времени, которое получил в предыдущем материале.  Теперь - самое важное: скормить гуглу хаос - и убедиться в степени хаоса как в массиве 512Б, так и в 20МБ-файле. А гугл сказал: пофиг, что я говорил раньше, - файлы не приму - вот тебе исходники энтропии Шеннона, иди гуляй. Ладно, адаптировал под билдер, посчитал - энтропия всего файла 6, энтропия массива 4.6-6. Средне-высоко. Но должно быть 7.5-8. Увеличил константу, прибавляемую к long double, до миллиона и с огромным хвостом - файл стал 7.5, но массив 4.6-6.8. Проблема ещё и в том, что мусор сжимается на 60% архиватором в ZIP; а также наличии в Блокноте переноса строки и всегда буквы M после него (в Notepad++ - не воспроизводится). Неясно, откуда это берётся: потом M встречается, но не через каждые 10Б, - это не старший байт long double. А дальше обнаружилось: энтропия файла всегда высокая - а у блока плавает. Ну... посчитаем это за хаос в хаосе. 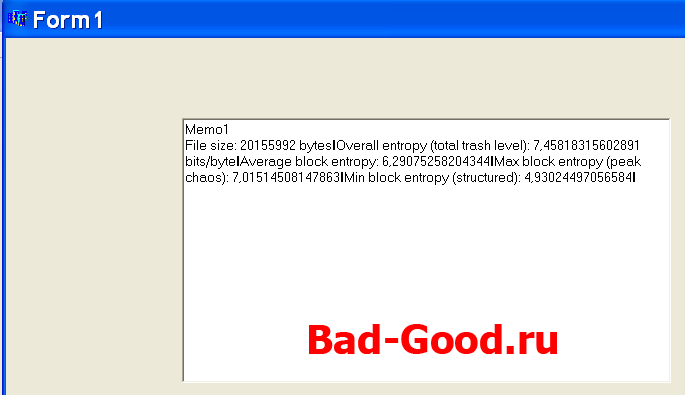 Теперь - можно условную скорость, придуманную для сравнения разных методов работы с данными, - перевести в настоящее удельное время обработки данных (удельная задержка). Для самой быстрой версии генератора данных порцией 512Б - 0.595нс/Б. А скорость генерации - 1.68ГБ/с. В 24.5 раза быстрее штатного. ...но, может быть, можно ещё быстрее?.. Ма. Ло. |
|
| Обновлено ( 02.11.2026 13:35 ) |