
| Быстрая рандомизация данных-4 (01.11.2026). |
|
| 2026 - Ноябрь | |
| 01.11.2026 09:22 | |
Я точно знаю, что среди вас есть суперпрограммист с зарплатой 500-700к, который читает материалы по данной теме (раз, два, три) и не прекращает ржать. Я этот смех прямо затылком чувствую. О, зумерское ещё: ты нарушаешь мои личные границы!11 Ой, как было бы хорошо, если бы он существовал на самом деле: такие проактивные люди своих не бросают - точно бы помог по форме обратной связи. Значит, текущая аудитория, читающая данный материал, не обладает чрезмерно избыточными навыками программирования и такой зарплатой - и можно позволить себе всё что угодно: всё равно никто ничего не заметит. Не надо включать перфекционизм, не надо пристально изучать скрин текущего быстрого алгоритма генерации ниже: вам это не принесёт никакой пользы. Никакой пользы, никакой. ...хватит смотреть на скрин... ...бл... В Borland C++ Builder v.6.0, при использовании кучи, - были получены быстрые условные результаты оценки скорости работы генерации данных: 237мс/Б при циклической работе с объёмом 512Б (размер физического сектора большинства носителей информации), 200-203мс/Б для меньших объёмов 16-64Б. Ускорение относительно штатного: 29.2 раза для порций 16-64Б, 24.6 раза для порции 512Б - мало, надо больше, хочу сотку. Если не в условных числах выражать - генерация 16.9ГБ/с при слабой частоте потока 3.57ГГц. Информация не генерировалась, а перемешивалась, - превращая псевдохаос в RAM в истинный хаос в выходном массиве. 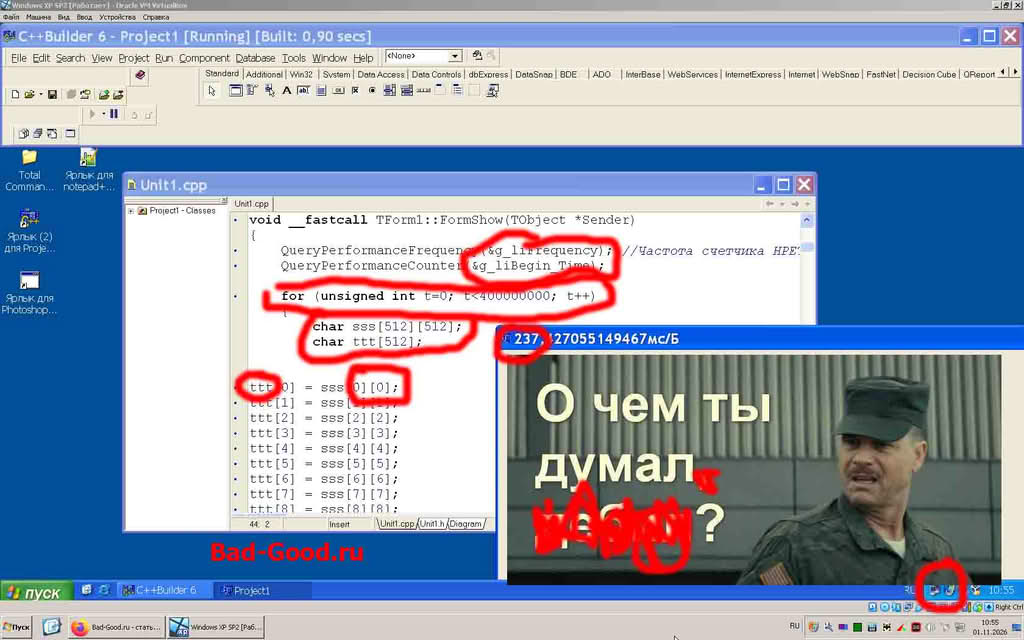 Абстрагировавшись от алгоритма, принялся за BLAKE3. Вышла неудача - стоит описать лишь кратко: - так и не удалось заставить работать первичные исходники. Ошибка за ошибкой сборки, исправляешь - лезут новые, пока не натыкаешься на undefined external-переменную, которой вообще в исходниках полнотекстовым поиском не существует, - и полностью стопоришься; - с чего решил, что исходники эталонные: только потому что скачанная папка содержит гигантское количество файлов? ИИ-гугл, фас - нашёл исходники - которые тоже не заработали. Пишу ему: ты мудак - отвечает, что да, - предлагает исправленные исходники. С изменением констант, неправильными дефайнами, неправильным количеством входных параметров в разных функциях. Ладно, исправлял, - запустил-таки. Скорость - непотребная, выход - 32Б. Пишу ИИ: ты уверен, что это BLAKE3, а не BLAKE2? Да-да, но вот в билдере надо изменить ещё функцию финиша - на тебе исправную, может буфер любого размера делать; - согласился. Потому что при работе функции апдейта без функции финиша - скорость работы 88мс/Б, очень лакомый кусочек. Сначала перерыл функцию апдейта - нашёл буфер 54x8Б - надеялся, что отсюда возьму хаос. Но хаос не обновлялся никогда, какие входные параметры в алгоритм ни суй. Переключился на функцию финиша - а чем больше размер буфера, тем медленнее она работает. Остаётся только зафиксировать, что BLAKE3, даже кастрированный однопоточный, - быстрее SHA512, но не в 10 или сколько там раз, - а только в 1.5-2. Провал. Вернулся к алгоритму 237мс/Б - а он стал 260мс/Б. Выяснилось, что чем больше исходников в Unit1.cpp - тем медленнее работа. Убрал - вышел на 249мс/Б. Убираю все инклуды сторонние - нет реакции. А потом дошло: - виртуалка имеет сетевую карту; - перелёг на кровать - включил RAdmin - подключился; - передача изображения по сети периодически просаживает ЦП - время работы алгоритма увеличилось до 249мс/Б; - если на экране больше исходного кода - больше чёрных точек на белом фоне - больше изображение для передачи - больше проседает ЦП - больше проседает алгоритм - 260мс/Б; - выключить в виртуалке сетевую карту на хрен - и коннектиться только к родительской ОС, чтобы смотреть из неё на виртуальную. Виртуалка на 3-7 потоке висит, реальная сетевая карта и ОС висят на 0-1 ядре - не пересекаются. Вторая критическая ошибка: говорил про кучу - динамическую память, а использовал по факту кучку - стек. Да, стек быстрее динамической памяти, - но страдает степень хаоса: максимум из пары мегабайтов берётся информация вместо 3.5ГБ и выше. Выхода 2: тестировать алгоритм как есть, создав тонну записей в файле по 512Б и оценивая их хаотичность-повторяемость (ещё и этот вопрос изучать), либо динамический массив входной сделать и посмотреть, насколько испортится время. В процессе анализа ошибки выше, выяснилась ещё другая проблема. Я вообще не представлял, как работает стек (а также, что существует элемент между стеком и кучей, - чпок, добрый вечер: 28 лет программирования - в утиль): - не стек тормозит, если массив в нём большой. Забивая стек другими данными, практически до переполнения, - алгоритм меняет скорость в медленную сторону всего на процент. А вот если массив сделать 1000x1000 и держать стек без дополнительного мусора - время увеличится на 88%; - глобальные переменные - живут в месте со странным названием "сегмент кода" (какой сегмент? Какого кода?) размером 2ГиБ. Но если ты их объявишь как new - переместятся в кучу. Стек - быстрый (с L1-кешем процессора работает - при его самом малом размере), сегмент - средний (с L1-кешем процессора работает), куча (с L1-2-3-кешами процессора работает) - самая медленная. Связана ли скорость стека с размером L1-кеша - загадка ("1-3 такта ЦП" - это как-то совсем неточно); - стек имеет размер 1МиБ во всех C-подобных языках, его размер меняется в настройках проекта: линкера-линковщика. Сунулся в билдер - размер 0x100000 - верно. Увеличил в 10 раз - прокатило, но скорость упала до 241мс/Б. Увеличил в 100 раз - не прокатило: максимум 10МиБ. Сравнял минимум 0x2000 (8192Б) с максимумом - прокатило, 241мс/Б. Вернул обратно минимум и максимум - 241мс/Б. Да какого х..я?? - при уменьшении стека, требуется перезапуск билдера, а не выйдет - и ОС. Нужно решить после тестирования 1МиБ и 10МиБ стека - стоит ли жертвовать 1.02% времени ради повышения степени хаоса. Третья критическая ошибка: промахнулся с нулём в цикле - скорость генерации не 16.9ГБ/с - а 1.69ГБ/с. Меньше, чем у SSD M.2, - стало критически мало. Цикл с 400млн - потребляет 1149мс. Нужно вычесть это время из функции расчёта времени, до деления на количество байтов. Множественное измерение 100-200 раз - и точность получается до 1мс. И вот, настал момент. 1-мерные оба массива, ИИ сгенерировал 512 строк - запуск. Никакого прироста в скорости нет: компилятор умеет быстро бегать по диагонали 2-мерного массива. Мало того, даже есть намёк на замедление на 1-2мс/Б, - но потом, при множественном просматривании числа, - намёк пропал. Сделал динамическим большой массив - настолько сильное замедление скорости (за несколько минут - сделал всего 300к из 400млн), что ждать не было смысла. Значит, идея с кучей - потерпела полный крах, и остаётся - только стек, со своей огромной скоростью работы. Значит, увеличение стека до 10МиБ - опция, которую нужно доказывать анализом степени хаотичности данных 1МиБ и 10МиБ. Никакие извращения с указателями, в т.ч. предлагаемые ИИ, - не смогли обеспечить меньшее время работы. У стека есть свои преимущества. В основном, в нём техническая информация, - нет содержимого жёсткого диска (которое всегда в куче). Значит, степень хаотичности самого стека - выше кучи: не страшно нарваться на текстовый файл, который спалит зачистку свободного места на носителе своими большими кусками. А это значит, что можно попробовать memcpy по 4 элемента за раз - и, опять же, сравнить степень хаотичности с предыдущим вариантов. А это означает: точно будет пятый материал, посвящённый такому сложному математическому вопросу. Это точно пятак за магистерскую, если бы это была дипломная работа, - без вариантов. (добавлено 02.11.2026) А часть 5 - вышла трешовой, но с правильным результатом. (добавлено 03.11.2026) Продолжение анализа вопроса: генераторы внутри генераторов. (добавлено 05.11.2026) (суровый молчаливый взгляд человека, повидавшего некоторое дерьмо) (добавлено 06.11.2026) ...и ещё 1 быстрый генератор на подходе... 2 прикола обнаружилось: - то ли дочерняя ОС, то ли виртуалка, то ли родительская ОС - решила попереключать выполнение кода между реальными потоками ЦП, а то и давая парочке поработать вместе. Для чего - непонятно, но задержки это точно порождает; - поток: может работать на частоте ядра - да ещё и разогнанного, если он забит один. Так и получилось: внутри виртуалки QueryPerformanceFrequency возвращает 3.57ГГц - полностью в соответствии с ТТХ Xeon E2696 V2 для 1 ядра с Turbo Boost. И сам Turbo Boost у Intel кастрированный: частота - от загруженных ядер зависит. 3.57ГГц - максимум, 3.3ГГц при загрузке всех 12 ядер - минимум. При этом в первом случае поток сожрёт всю частоту ядра на постоянной основе, а во втором - пара потоков будет переключаться в рамках принадлежащего им ядра - всё равно частота не половинится.(добавлено 07.11.2026) О Turbo Boost. Так как он неадекватно влияет на частоту ядра - при измерении времени и родительскую ОС нагружать нельзя (или радикально отключить авторазгон в BIOS). Иначе измерит всё при QueryPerformanceFrequency 3.4ГГц, а разово её возьмёт при спаде нагрузки 3.57ГГц, - и число в секундах, и частота при измерении этого числа - будут неверны. (добавлено 08.11.2026) ...чуть-чуть осталось... (добавлено 11.11.2026) Об энтропии Шеннона. Протестировал граничный размер сегмента данных для Borland C++ Builder v.6.0. 52МБ (не МиБ). Между 52 и 53 мегабайтом - возникает неопределённость стабильности. Может заработать. Может ошибку линковки показать, убрать её и заработать. Может свалиться. Таким образом, трата 16МиБ моим генератором - корректная величина, и у разработчика есть ещё 35.223МБ объёма для своих переменных. |
|
| Обновлено ( 11.11.2026 12:21 ) |