
| Погрешности long double (25.06.2026). |
|
| 2026 - Июнь | |
| 25.06.2026 09:12 | |
Любое дело, к которому прикасается государство РФ и его прихвостни, - быстро превращается в говно. Начиная от высшего образования и заканчивая ценой-качеством утильсборного автопрома, блокировками интернета, испоганиванием яндекса-мейла-вконтакте-макса, торговой биржей, стоматологией, экстремизмом и т.д. - опыта на этом сайте более чем хватает. Если хочется жить нормально - рано или поздно приходит понимание: не стоит связываться с такого рода вещами (однозначно, проиграешь). Напротив, дела о внутренностях техники-физики-химии, подчиняющиеся вполне конкретным законам, - вполне и изучаемы, и доводимые до конца (если продукция сделана качественно). А главное, при должной сноровке, - полностью предсказуемы, т.к. государству (пока) до этого дела нет (исключения - Astra Linux, ГИС и т.д.). Предсказуема ли погрешность long double? Это смотря под каким соусом её жрать.
Началось всё с написания самой тяжёлой и масштабной в жизни работы: анализатора площадных зон планеты. Еле-еле хватило точности long double в Qt v.5.3 64bit на Astra Linux v.1.4: при разрешении мировой карты 1мс (100мс/с: требовалась точность много больше общепринятой) - погрешность работы с уравнениями прямых составила < 0.5мс (прям пограничное значение - когда ещё работают математические правила округления). Данный результат не только был везением: он не был достойно протестирован - оставаясь слабым местом в программе (избирательное ручное тестирование), наравне с тестированием площадных зон (использовались те, которые давали, а не созданные по своим правилам). Время шло - вернулся к задаче создания генератора площадных зон. И если ранее это была стажёрская задачка с уравнениями прямых без каких-либо ограничений, необходимости точных вычислений и на малом участке мира (он, естественно, не справился) - то теперь это превратилось в масштабную задачу, охватывающую всю планету. Понимая, что точность требуется просто бешеная: было принято решение начать с удобства разработки - Astra и Qt получили пинок под зад. Вернувшись в старую-добрую хрюшу и ворча на Borland C++ Builder v.6.0, приходит и эксперимент: потянут ли 32-битные программы такую задачу. А это разбивается на подэксперименты: хватит ли разрешения TBitmap для самоконтроля генерации зон с аппроксимацией (43200x32400 пикселей), хватит ли погрешности long double для получения результирующей погрешности <0.5мс и т.д. Изучение теории с помощью разных ИИ - оказалось ещё одним гвоздём в их гроб (результаты были получены именно для данной версии среды программирования): - предлагает повысить точность вычислений long double с помощью _control87(), PC_80, MCW_PC в float.h. А константы PC_80 и не существует. В 2 соседних предложениях заявляет: PC_80 - не константа, но чуть ниже - пишет её постоянное значение. Естественно, использование значений 0x2 и 0x30000 (последние пробовал разные) - вообще точность вычислений уронило ниже плинтуса; - предлагает для сравнения long double функцию IsEqual с использованием fabs() и константы LDBL_EPSILON (нельзя long double сравнивать с помощью ==). Ладно fabs() медленная, но до 15 знаков всего - она только для double подходит, а для double в уравнениях прямых был уже произведён тест: провал - не хватает точности. ИИ тупо анализирует интернет, видит кучу одинаковых функций в ответах на каких-нибудь форумах - и просто помещает её в ответ без какого-либо анализа правильности; - то же самое касается функции randomize(). Она завязана на секундомере ОС: если её располагать в цикле >1Гц - рандомайзер сходит с ума и становится константогенератором. Правильное её расположение - однократно в FormCreate()/FormShow(), но так как весь интернет увешан неправильным её использованием - ИИ и считает неправильное правильным. В очередной раз поняв, что от ИИ толку не добьёшься, - пришлось сформулировать свои критерии расчёта погрешности: - LDBL_EPSILON имеет значение 1.084202172485504434e-019L. Но это не имеет никакого значения; - чем большее число помещается в переменные с плавающей точкой - тем больший хвост после запятой будет отсечён. На этом основан баг pow() в разных средах программирования на основе C: пока свою на основе __int64 не напишешь - будет врать (в Qt с 53 степени, в другом каком-то языке с 22 - что намекает на разные погрешности одних и тех же типов данных в разных средах разработки); - в уравнении Y = kX + b: k - выступает в роли множителя погрешности, находящейся в X. Получается, если X и k большие - погрешность при использовании такого уравнения будет бешеная; - к счастью, макетирование показало: приравнивание двух long double друг другу - дополнительную погрешность не порождает (число со своей погрешностью - точная копия). Реализация: - написана своя функция получения погрешностей при работе с long double без fabs(); - использовалось уравнение прямой Y = kX + b и реверсивные вычисления (самоконтроль ПО и обнаружение погрешности в одном флаконе); - использован генератор координат с максимумом 1млн; - реверсивные вычисления невозможны с параллельными прямыми относительно друг друга и относительно осей координат (деление на 0) - в этом случае, к одной из координат прибавлялась 1мс; - выполнены 126млрд вычислений дважды. Показали невыход за погрешность 4.5475e-013L - между 12-13 знаками, отличный результат. Но стали возникать сомнения - было решено перебором всех возможных комбинаций точек найти наибольшую погрешность; - как и в прошлый раз, выгодно использовать уравнение прямой с 2 неизвестными, а не с 3: планируется огромное количество вычислений и потребление ~1ГБ RAM на каждую площадную зону. Вот тут-то писец и пришёл: - при разрешении карты 129.6млн миллисекунд - число вычислений для всех уравнений прямой составит 129.6млн4, а для пересечения всех прямых - 129.6млн8. С квадриллионными числами уже работал без проблем - но это число выглядит как выставленный штраф гуглу от РФ (государственные гопари создавали контент с нарушениями - для создания огромного количества заявок - для выписывания гигантского штрафа невыполнения заявок - чтобы вытеснить гугл из РФ - чтобы все в православном хуяндексе принудительно сидели - благо, не получилось). Тут многопоточность уже ничего не значит: вычисления займут тысячи лет; - было решено пока с разными дискретами в циклах 500.000-800.000мс пробежаться - и была получена погрешность 4.621e-04L. При этом, она сосредоточена в X1 2млн, Y1 ~115.8млн, X2 23.1млн и каком-то Y2. Скорее всего, там просто гигантское число k, - анализ проводиться не будет; - чтобы корректно уточнить полученную погрешность и не погрязнуть в вычислениях, нужно дискреты циклов обозначить 1 градусом или 1 минутой. Это охватит 360 или 21600 возможных вариантов наклона прямой - и при этом многомиллионные значения попадут и в X, и в Y (тут главное пограничный результат захватить, используя граничное число 129600001). Результат градусных наклонов - 4.6362...e-04L за несколько часов, минутных - будет работать в 12.96млн раз дольше. Нужно решение о многопоточности принять, или системник оставить на неделю-2 включённым, или всё вместе сделать, или забить болт. А также исходники причесать; - получается, максимум числа был увеличен с 1млн до 129.6млн (+2 десятичных разряда), а погрешность - улетела в скратосферу +9 разрядов. Промежуточные итоги для работы с уравнениями прямых на карте мира с разрешением 1мс при 100мс/с: - погрешность вычислений составит <4.6363e-04L миллисекунд при использовании самого точного типа данных long double - меньше никак не сделать. Но для определения точки пересечения двух прямых - эта погрешность будет больше; - есть вероятность, что погрешность будет меньше, чем в Qt. А это будет значить, что в принудительно навязанной Qt: удалось реализовать то чудище несколько лет назад успешно - чисто по везению, пройдясь по лезвию ножа; - теперь, зная реальное значение погрешности, - можно функцию её определения переписать многопоточно (есть за какое число цепляться для оценки качества работы потоков). Плюс получение результата одним 6-часовым прогоном - наверняка, мало; - поэтому, продолжение (или болт) - следует... (добавлено 26.06.2026) Причёсывание исходников привело к тому, что возросла скорость расчёта погрешности с 6ч до 4ч (номинал погрешности - тот же). Перерыв весь Math.h, нашёл внутри fabsl() - скорость работы как у моей самописной, работает корректно. Создание механизма многопоточных вычислений - теперь скорее рутина, чем интересное программирование (и перетаскивание заготовок из одного проекта в другой - происходило медленно и с постоянным зеванием). Однако заготовка из грязновой стала чистовой - и теперь просто подключается к любому проекту парой файлов, а не как ранее была сильно завязана на форме. Когда она заработает - есть смысл её потом добавить в полезные исходники и в обучающий материал с многопоточной программой расчёта простых чисел. (добавлено 29.06.2026) Причёсывание исходников привело к тому, что возросла скорость расчёта погрешности с 6ч до 34.7мин (при добавлении одной строки с fabsl() - на 10% дольше, то есть она дохрена жрёт). Параллелизм должен уменьшить до 3мин (застрял в разбивании объёма вычислений на части при разных дискретах в циклах). Тогда уменьшение дискрета для прямых с 1град до 6мин - будет считаться 21дн. Сколько времени будет считаться пересечение прямых как следующий этап анализа - точно рассчитать невозможно. Вместо прибавления к long double в цикле: стал прибавлять не числом 360000, а 4-байтный unsigned int - значение погрешности не изменилось. Как, впрочем, и скорость - похоже, без разницы, как числа к 10 байтам прибавлять: всё равно медленно. Имитация использования X первой прямой в уравнении второй прямой: самое большое k второй прямой (129.6млн вышло - сначала не понял, верен ли автоматический расчёт) умножалось на максимальную погрешность первой прямой. Максимальная погрешность при пересечении прямых - вышла 60086мс (второе число для проверки корректности будущего параллелизма получилось). Провальный результат - неизвестно, стоит ли продолжать разработку дальше (ситуация реальная: такое большое k возможно при Y=129.6млн, X=1 и b=0). С другой стороны, в X=1 погрешность точно не будет максимальной из-за всего одного десятичного разряда - и спокойно может быть и e-019L, характерной для long double, - и итоговая погрешность будет малой. Очень хотелось бы надеяться, что итоговая погрешность для двух прямых будет квадратом от полученной для одной прямой. Но это тоже вопрос вероятности. (добавлено 30.06.2026) Закон Мерфи в силе, как обычно (в распределении объёма по потокам - не было ошибок): - думалось, что большие числа обрабатываются дольше маленьких (чем больше битов занято - тем дольше). Разница была видна в диспетчере задач: потоки завершаются в разное время; - а вот механизм слежения за потоками - показал совсем другую картину: потоки просто тупо завершаются в разное время. Сначала всё было многообещающим: закончил работу сначала поток №1, затем №2 - но потом закончил №7, потом №9. После другого запуска - №№8-1-4-11. Время между первым и последним потоком тоже плавает от запуска к запуску: 1-22%. И чем это объяснить - х.з.; - появилась новая команда: Sleep(). Она не уменьшает нагрузку на поток, но уменьшает влияние потоков друг на друга. В итоге, при Sleep(100) получилось среднее время (оно тоже скачет: 270-410с, например) 340с, при 1000 - 380с, при 10000 - 380с (неточно: не было времени десятки раз гонять); - когда фокус на форме, которой управляет родительский поток, - время выполнения 340с. Стоит переключиться на другое приложение (перекрыть форму) - 278с. Только потом стало ясно, что это тоже просто совпадение. Итоговое ускорение - не в 11, но в 6.3 раза. (добавлено 04.07.2026) Опять в тонкости параллелизма занесло - разработка генератора откладывается. Есть вероятность уменьшения времени расчёта погрешностей уравнений прямых с десятков дней до единиц - нельзя упускать такую возможность. И сделать на основе уравнений прямых - одновременно и диагностический механизм работы с потоками, и заготовку для работы с ними на максимальной скорости. (добавлено 16.07.2026) Очень сильно заморочился - выяснилось, что погрешность не 4.6363e-04L, а 4.4791e-04L (была ошибка в расчёте диапазона вычислений). Но это только с дискретом 1град - число вырастет снова при уменьшении дискрета (дискрет 0.5град - 4.5577e-04L). (добавлено 18.07.2026) А вот погрешности точек пересечения прямых - прут очень высоко. Это очень ресурсоёмкая задача оказалась (8 вложенных друг в друга циклов, повышенная нагрузка в последнем цикле) - даже оптимизированное раскидывание её на потоки ЦП не решает проблемы. Уже сейчас получено значение 0.07мс - очень близко к оптимальной 0.1мс и к минимально необходимой 0.5мс. Если превысит 0.5мс - точности long double не хватает для охвата карты мира с точностью до 1мс. Рисунок пока, с недописанным до конца функционалом - показывает 0.03125мс. 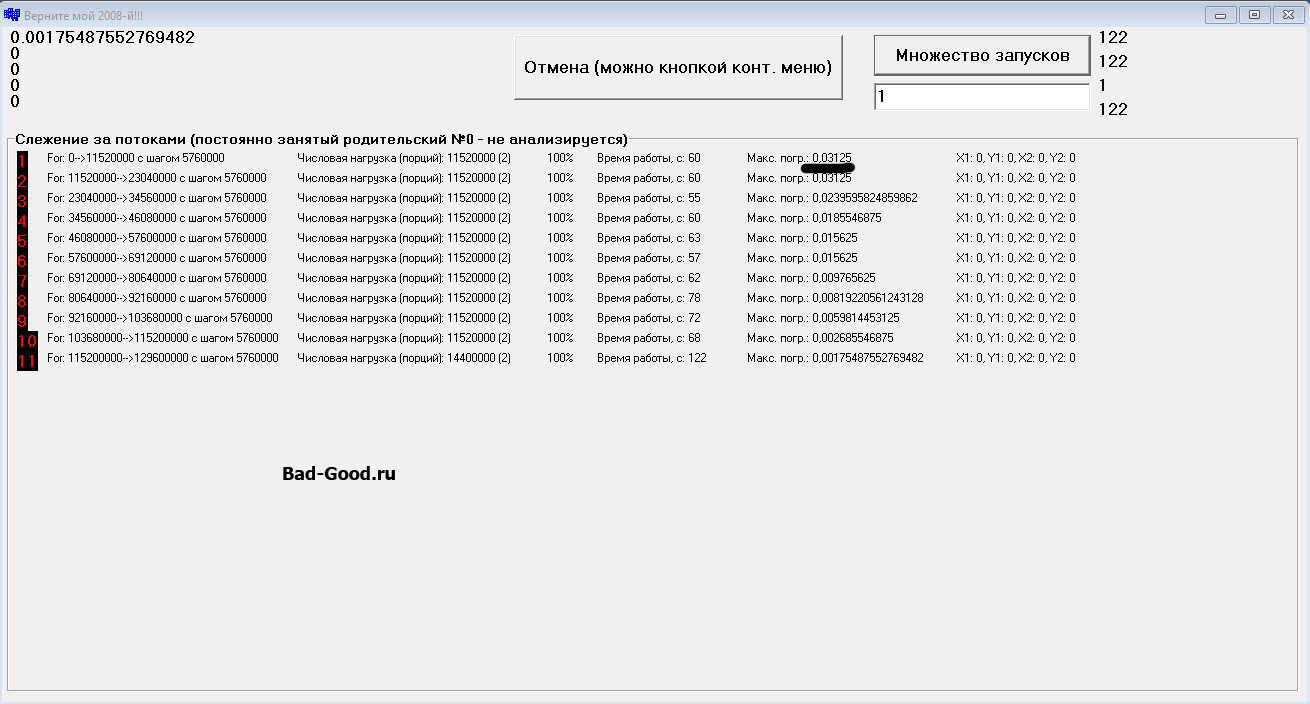 (добавлено 21.07.2026) Вышел на погрешность 0.125 (считалась почти 3 дня) - становится жарко. Погрешность сосредоточена в 2 первых потоках - метод последовательного приближения можно применять. Попытался в оптимизацию тела самого внутреннего цикла (их же 8шт друг в друге) - надо её пересчитать заново, чтобы убедиться в сохранении чисел и уменьшении времени работы. И шаг пока меньше 2.160.000 использовать не удаётся: каждое уменьшение шага в 2 раза - приводит к увеличению времени выполнения в 256 раз. 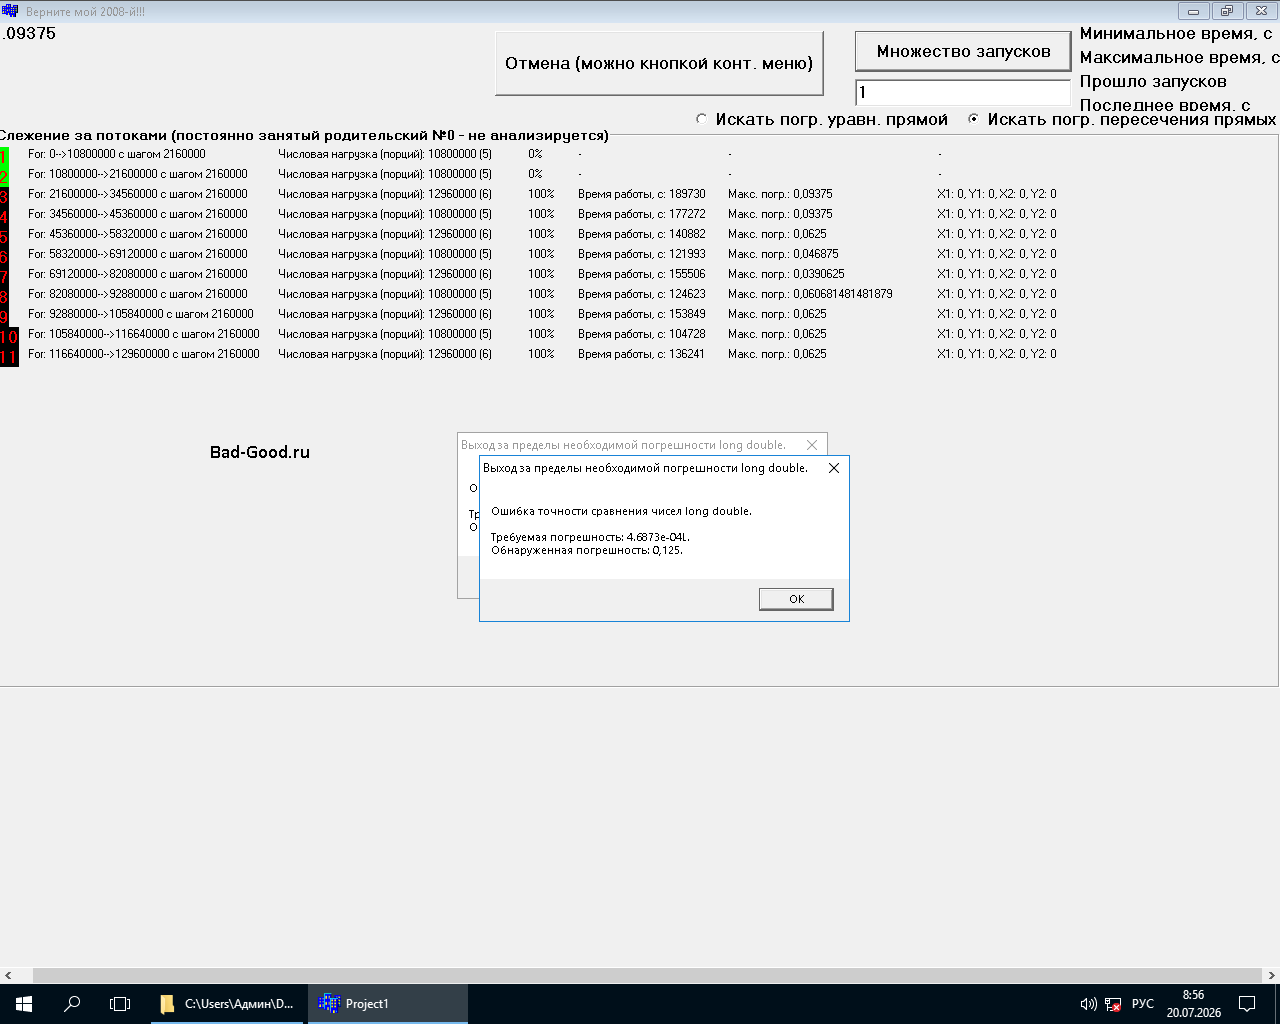 (добавлено 22.07.2026) Не успел. СБ не понравилось, что на ПК стоит винда вместо линукса. Я отсутствовал - они уничтожили результаты вычислений за несколько дней, выключив ПК. Теперь вообще не уверен, что работа будет продолжена. (добавлено 25.07.2026) Не, ну это полный писец. И сюда уроды влезли - и испортили все расчёты, и вообще дело полностью. (добавлено 26.07.2026) Надо как-то корректно завершить эту работу. Выкладываю сюда завершённые исходники по расчёту (но без завершённых самих расчётов): 1.28МБ. А также CPP- и H-файлы функций по работе с потоками. Их можно использовать как заготовку, если поток всего 1. Если потоков много - 2-х файлов будет недостаточно: надо делать где-то 8: Threads_Main, Threads_Classes, Threads_Global, Threads_Executes и т.д. (добавлено 27.07.2026) Пересмотрев исходники в блокноте - понял, что сильно накосячил, увлёкшись потоками (плюс напрочь забыл про проекцию Меркатора): - по оси Y чисел должно быть в 2 раза меньше - скорость вычислений возрастает в 16 раз; - нулевые координаты в левом нижнем углу карты, а не по её центру, - есть вероятность уменьшения погрешности в 2 раза; - вместо if (uiMode == N) (планировалось 4 режима работы): нужно использовать if (bMode) - увеличение скорости работы; - размер исходников стал меньше, т.к. из архива удалил сейчас временные файлы. (добавлено 29.07.2026) Запустил-таки макетирование на ПК - выяснилось, что условия отбрасывания прямых в теле самого глубокого цикла - оказались неверными. Топорные и медленные условия находили погрешность 0.125мс - а на том, что сейчас в ускоренных исходниках, - получилось только 0.0625мс. Предыдущие условия, дающие 0.125мс, - утеряны в писеце от 25 числа. (добавлено 01.08.2026) Формулы в самом глубоком цикле - верны. Нашёлся алгоритмический косяк функции сравнения чисел. Похоже, придётся исходники обновить спустя время - иначе это выглядит как быдлокодинг какой-то. Получил снова погрешность 0.125мс именно в 2 первых потоках (полностью данные со скрина выше) - используя совершенно другие условия проверок. (добавлено 04.08.2026) Интересно получилось: первые 2 абзаца статьи - оказались пророческими. Если бы СБ не влезла в процесс - всё было бы закончено до конца, в гораздо меньшее время, с меньшим количеством ошибок. Похоже, мой альтруизм уходит окончательно; и заниматься этим вопросом дома в свободное от работы время - желания особо нет. Исходники - обновил; но там всё равно есть косяки. Возможно, позже, - доведу их до конца каким-нибудь другим способом. И на выходе - получится корректная заготовка для работы с потоками (как переработка этих исходников). Уже сейчас есть идеи ещё большего ускорения работ с высоконагруженными задачами - класс потоков обрастает всё большим количеством необходимых переменных. (вечером:) Уже получено значение 0.375мс. Всё ближе к числу 0.5мс, указанному в моем модуле по работе с картами; >0.5 - модуль скрытно неправильно работает. Погрешность очень странно располагается по потокам. Ранее чётко была в первом и втором потоках (пока дискрет уменьшаться не начал). Но при анализе с дискретом 216000 диапазона 2160000: второй, третий, седьмой, десятый, одиннадцатый потоки - одинаковые и максимальные номиналы (расчёты приостановлены). Возможно, связано с тем, что к номиналу становится приближаться всё сложнее: уменьшение дискрета ещё - приводит к дням работы, а неуменьшение - вот к такой вот проблеме. Теперь надо думать, как из этого выкручиваться. (добавлено 05.08.2026) Не получается ни до 100% анализа добраться (сделано <11% почти за сутки), ни правильно выбрать ту часть данных, в которых погрешность наивысшая. Придётся выбирать наугад.  (добавлено 08.08.2026) Остановил попытки добраться до истины: с надзирателями ещё проблемы пошли. Не буду рисковать собой с целью сделать продукт предприятия лучше: если за это дают по шапке абсолютно дикими образами. Скорее всего, надо заканчивать трудоустройство в этом месте. Посмотрим, повысят ли через месяц; если и там палки в колёса будут ставить - максимальный репост ситуации на предприятии и уход с окончанием СВО. (добавлено 27.08.2026) Добавил корректную функцию распределения объёма данных по потокам. Поддержка этих исходников теперь - полностью остановлена. (добавлено 11.09.2026) Создана заготовка для быстрого использования многопоточности и параллелизма - для Borland C++ Builder v.6.0. |
|
| Обновлено ( 11.09.2026 10:27 ) |